Neste módulo, serão vistos conceitos importantes da programação em R, envolvendo os tipos de objetos, as estruturas de dados e a lógica de programação.
Tipos de dados vs. Estruturas de dados
Para programar em R sem frustrações, o segredo é entender uma distinção fundamental:
O tipo de dado é o conteúdo (o “material” do qual o dado é feito: número, texto, lógico). A estrutura de dados é o recipiente (a forma como esses dados são organizados no espaço: em fila, em tabela, em gavetas).
Principais estruturas de dados no R (Adaptado de venus.ifca.unican.es/Rintro/dataStruct.html)
Podemos resumir as estruturas em duas dimensões práticas:
Dimensões
Todos os elementos do mesmo tipo (Homogêneo)
Elementos de tipos diferentes (Heterogêneo)
1D (Fila)
Vetor atômico
Lista (o “armário de gavetas”)
2D (Tabela)
Matriz
Data frame / Tibble (a “planilha”)
nD (Multidimensional)
Array
(não aplicável)
1. Os tipos atômicos de dados (o conteúdo)
Antes de falarmos dos recipientes, vejamos os quatro tipos elementares que preenchem qualquer análise:
double (numérico decimal): valores contínuos (ex., altura de planta 1.75, massa de grãos 28.4).
integer (número inteiro): valores de contagem (ex., 3L repetições, 15L vagens). No R, acrescentamos um L maiúsculo ao final para forçar o tipo inteiro.
character (texto / string): palavras, nomes ou códigos delimitados por aspas (ex., “Hibrido_A”, “Bloco_1”).
logical (booleano): valores binários de verdadeiro ou falso (TRUE ou FALSE).
Agora que conhecemos os materiais, vejamos os recipientes onde eles são guardados.
Vetor atômico: a fileira de tubetes homogênea
Analogia: Pense em um vetor como uma fileira de tubetes para mudas. Você pode encher todos os tubetes com terra (números) ou todos com substrato de casca de pinus (textos), mas todos os tubetes daquela fileira devem conter o mesmo material.
A função c() (combine ou concatenate) é a ferramenta usada para criar vetores:
Se você tentar misturar tipos diferentes em um vetor, o R não vai dar erro; em vez disso, ele silenciosamente converterá todos os elementos para o tipo mais flexível (geralmente texto!). Isso se chama coerção:
{r} mistura <- c(10, 25.5, "Tratamento_A", TRUE) mistura typeof(mistura) Note que os números e o TRUE viraram texto (“10”, “25.5”, “TRUE”). Cuidado com isso ao importar planilhas!
Sequências e repetições rápidas
Em vez de digitar item por item, usamos funções utilitárias:
`{r} # Sequências 1:5 # De 1 a 5 seq(from = 10, to = 50, by = 10) # De 10 a 50 de 10 em 10
Repetições
rep(“Bloco_1”, times = 4) # Repete 4 vezes o mesmo texto rep(c(“A”, “B”), each = 3) # Repete cada elemento 3 vezes `
Acessando elementos do vetor com colchetes []
Para puxar um elemento de uma posição específica da fileira, usamos [posicao]:
{r} alturas[1] # Primeiro valor alturas[c(1, 3)] # Primeiro e terceiro valores alturas[-2] # Todos EXCETO o segundo valor
Além do uso de [], as funções irst(), last() e th() do pacote dplyr permitem selecionar o primeiro, o último e o i-ésimo elemento de forma expressiva:
Usamos <- ou = para atribuição de nomes a objetos?
Em R, utilize sempre <- (atalho: Alt + -) para criar e atualizar objetos. O sinal de igualdade (=) deve ser reservado exclusivamente para definir argumentos dentro de funções (ex., mean(x, na.rm = TRUE)).
Fator: a caixa de etiquetas de tratamentos
Analogia: Um fator é como uma etiquetadora agrícola. No campo, você não tem números contínuos para os tratamentos; você tem categorias bem definidas (níveis ou levels), como “Sol”, “Sombra_30” e “Sombra_70”.
Por baixo dos panos, o R armazena os fatores como números inteiros (1, 2, 3), mas exibe rótulos compreensíveis. Isso é essencial para análises de variância (ANOVA) e modelos de regressão.
Analogia: Uma matriz é como uma bandeja de cultivo retangular com divisórias em linhas e colunas. Ela tem duas dimensões, mas continua sendo homogênea (todas as células precisam ser do mesmo tipo, quase sempre numérico).
Construímos matrizes com a função matrix() ou juntando vetores com cbind() (colunas) e bind() (linhas):
`{r} # Matriz de 3 linhas e 2 colunas (dados_campo <- matrix(1:6, nrow = 3, ncol = 2))
Indexação por [linha, coluna]
dados_campo[2, 1] # Linha 2, Coluna 1 dados_campo[1, ] # Toda a Linha 1 dados_campo[, 2] # Toda a Coluna 2 `
Data Frame e Tibble: a planilha de campo
Analogia: Um data frame é o clássico caderno de anotações de campo ou planilha do Excel. Ele tem linhas (observações/plantas) e colunas (variáveis). A grande mágica: cada coluna pode ter um tipo de dado diferente, mas todas as colunas devem ter rigorosamente o mesmo número de linhas.
Coluna 1: Nome da planta (character)
Coluna 2: Bloco ( actor ou integer)
Coluna 3: Altura em metros (double)
Coluna 4: Sadia? (logical)
{r} # Criando um data frame tradicional experimento <- data.frame( planta = paste0("P_", 1:4), bloco = factor(rep(c("B1", "B2"), each = 2)), altura = c(1.45, 1.62, 1.58, 1.70), sadia = c(TRUE, TRUE, FALSE, TRUE) ) experimento
Por que usamos o ibble?
O ibble (do pacote ibble / ecossistema idyverse) é uma versão modernizada e mais amigável do data frame: 1. Ao ser impresso no console, exibe o tipo de cada coluna (, , , ) e evita travar o R quando há milhares de linhas. 2. Não converte strings em fatores silenciosamente. 3. Permite criar colunas novas que dependem de colunas recém-declaradas no mesmo comando.
Analogia: A lista é como um armário gaveteiro de laboratório. Cada gaveta tem uma etiqueta própria e, dentro de cada gaveta, você pode guardar absolutamente qualquer coisa, sem restrição de tamanho, dimensão ou tipo!
Na Gaveta 1 ($projeto), guardamos um texto descritivo.
Na Gaveta 2 ($amostras), guardamos um vetor com números de amostras.
Na Gaveta 3 ($tabela), guardamos uma planilha inteira (um tibble)!
Na Gaveta 4 ($parametros), podemos guardar outra gaveta menor com notas técnicas (outra lista)!
{r} # Criando nossa lista (gaveteiro) gaveteiro <- list( projeto = "Avaliação de Linhaça 2026", # um texto amostras = c(101, 102, 103, 104, 105), # um vetor tabela = tbl_exp, # um tibble inteiro! responsavel = "Prof. Dr. Tiago Olivoto" )
Como abrir as gavetas e pegar o que está lá dentro?
Existem duas formas principais de acessar os itens de uma lista:
Pelo nome da gaveta com o operador cifrão ($): a forma mais intuitiva e recomendada.
Pelo número da gaveta com colchetes duplos ([[ ]]): abre a gaveta e retira diretamente o objeto de lá.
`{r} # Puxando o tibble da gaveta ‘tabela’ gaveteiro
Puxando o vetor da gaveta 2 com [[ ]]
gaveteiro[[2]]
Entrando na gaveta ‘tabela’ e pegando a coluna ‘prod_kg’:
gaveteiro `
Diferença crucial: [ ] vs [[ ]] em listas
gaveteiro[2] retorna uma lista menor contendo a gaveta 2 (você ainda está segurando a gaveta com o item dentro).
gaveteiro[[2]] abre a gaveta e retira o objeto que estava guardado dentro dela (você pega o vetor na mão, pronto para usar em cálculos).
Lógica de programação
É preciso mesmo compreender programação?
A programação é uma habilidade transversal necessária para todo o trabalho de ciência de dados (usando R ou não!). Resumidamente, a programação produz o código, e o código é uma ferramenta de comunicação entre você e o computador.
Funções
Uma das melhores maneiras de tornar o código mais eficiente é escrever funções. As funções são a base da linguagem R. Por meio de argumentos indicados em function(), uma expressão (ou série de expressões) é resolvida e um valor (ou um conjunto de valores) é retornado. As funções permitem automatizar tarefas comuns de uma maneira mais poderosa e geral do que “copiar e colar”. Escrever uma função tem três grandes vantagens sobre o uso de copiar e colar:
Você pode dar a uma função um nome evocativo que torne seu código mais fácil de entender.
À medida que os requisitos mudam, você só precisa atualizar o código em um local, em vez de vários.
Você elimina a chance de cometer erros acidentais ao copiar e colar (ex., atualizar um nome de variável em um local, mas não em outro).
Considere escrever uma função sempre que copiar e colar um bloco de código mais de duas vezes. Quando uma função está armazenada no ambiente de trabalho, basta digitar o nome com o qual ela foi gravada. Os argumentos podem ser inseridos na ordem em que aparecem na função, sem especificar a qual argumento cada valor pertence. Caso a ordem de inserção dos argumentos seja diferente daquela em que aparecem na função, é preciso identificar a qual argumento cada valor pertence. Note que é possível combinar valores numéricos e texto como argumentos e/ou resultados de funções. Veja alguns exemplos.
# EXEMPLO 1:# resolve a função 2x+1fun1 <-function(x){ # x é o único argumento da função a <-2* x +1return(a) # retorna a}fun1(2)
[1] 5
fun1(x =2) # explicita o argumento
[1] 5
# EXEMPLO 2# função para elevar ao quadrado ou cubo# inclui condicionanteselevar <-function(x, eleva ="quadrado"){if(!eleva %in%c("quadrado", "cubo")){stop("O argumento eleva = ",eleva, " deve ser ou 'quadrado' ou 'cubo'") }if(eleva =="quadrado"){ valor <-ifelse(x^2>=1000,paste("O resultado (",x^2,") tem mais que 3 dígitos"),paste("O resultado (",x^2,") tem menos que 3 dígitos")) }if(eleva =="cubo"){ valor <-ifelse(x^3>=1000,paste("O resultado (",x^3,") tem mais que 3 dígitos"),paste("O resultado (",x^3,") tem menos que 3 dígitos")) }return(valor)}elevar(2) # usa o valor dos argumentos
[1] "O resultado ( 4 ) tem menos que 3 dígitos"
elevar(3, "cubo") # argumentos na sequência que eles aparecem
[1] "O resultado ( 27 ) tem menos que 3 dígitos"
elevar(eleva ="cubo", x =15) # mudar a ordem dos argumentos
[1] "O resultado ( 3375 ) tem mais que 3 dígitos"
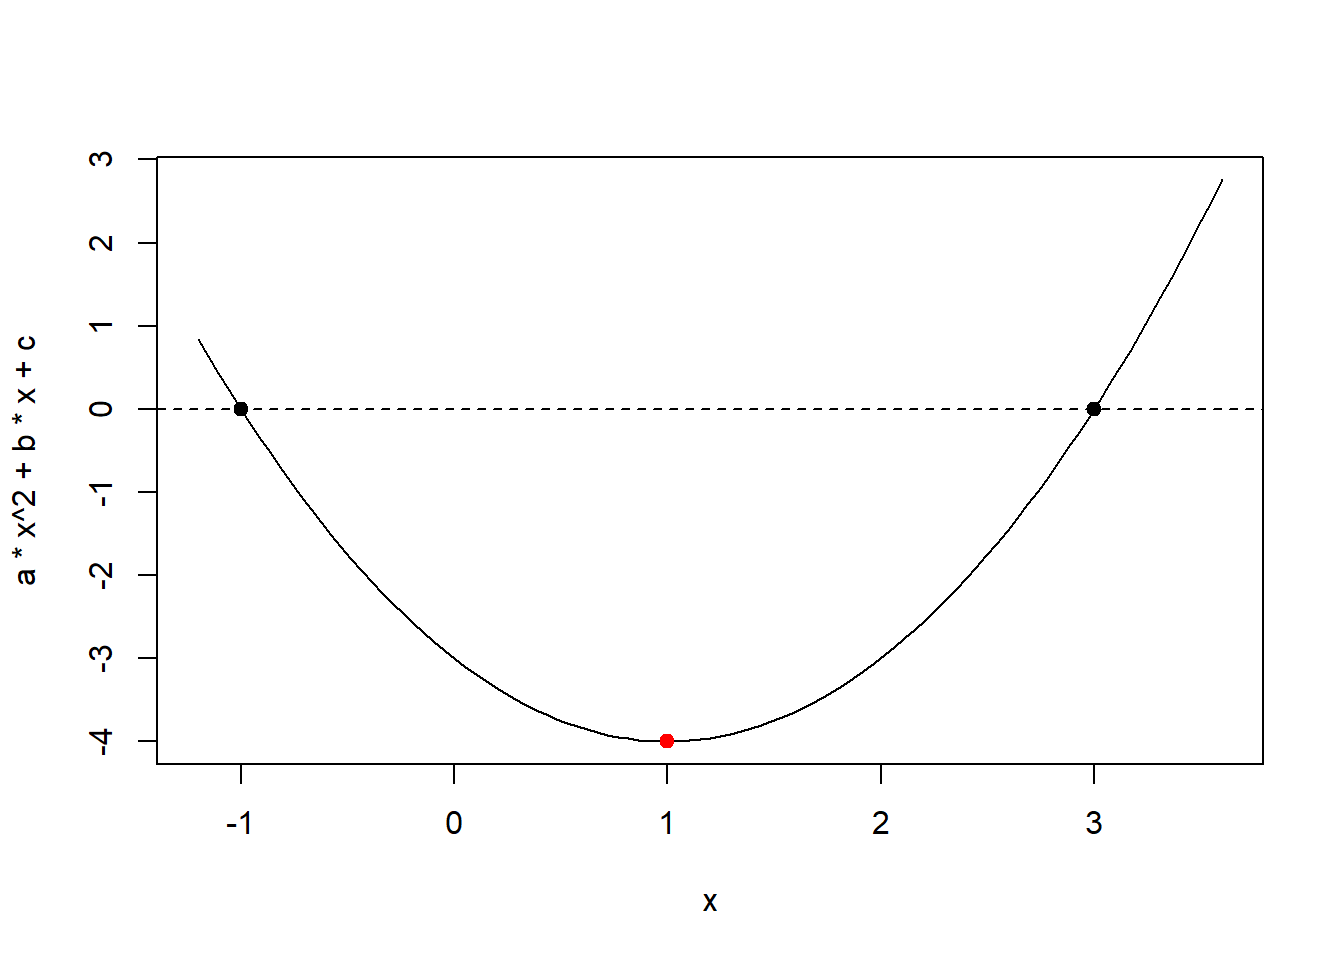
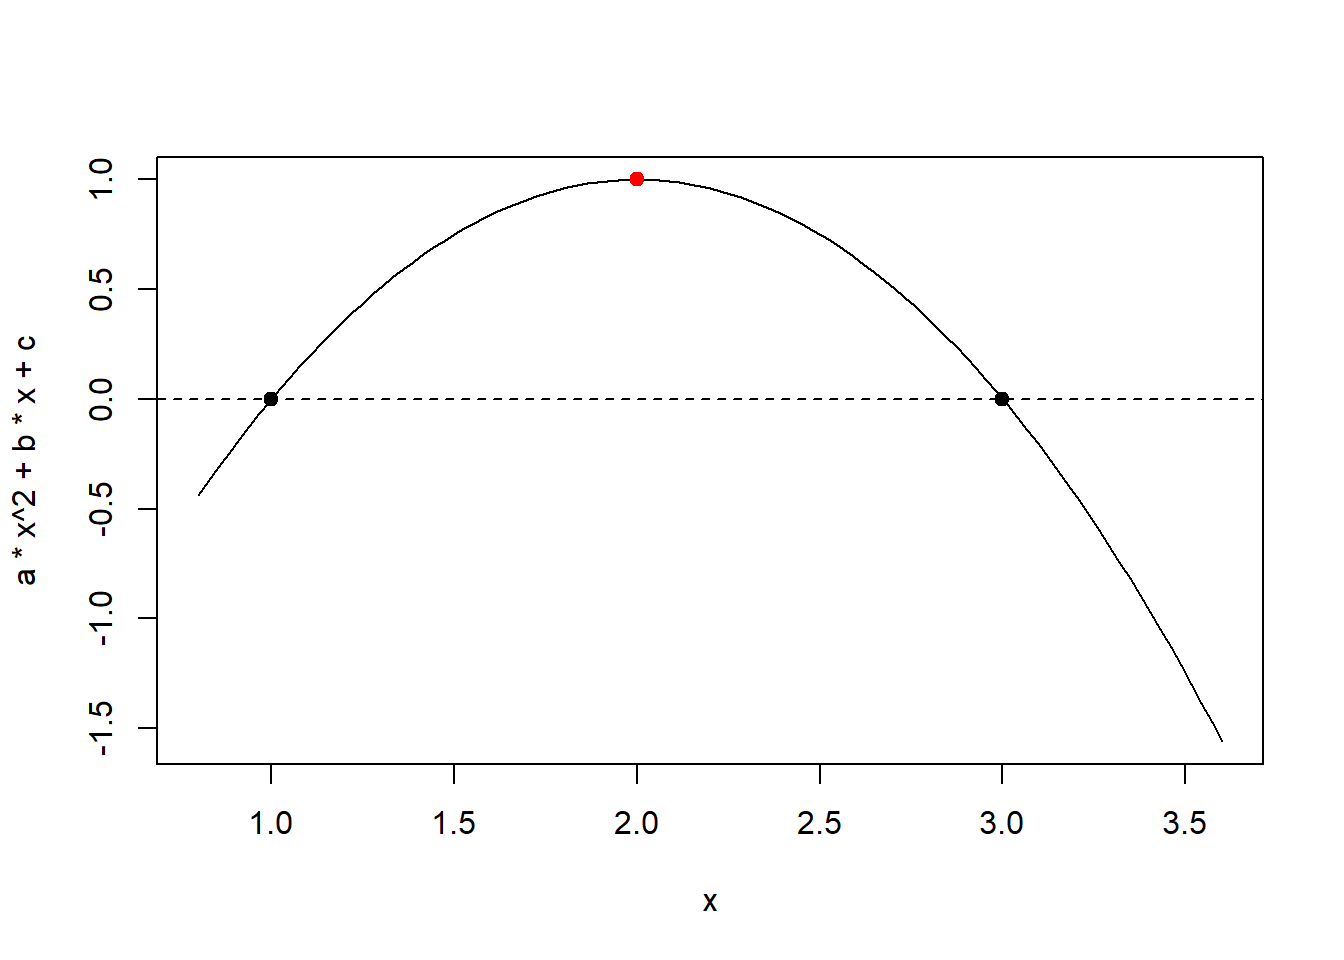
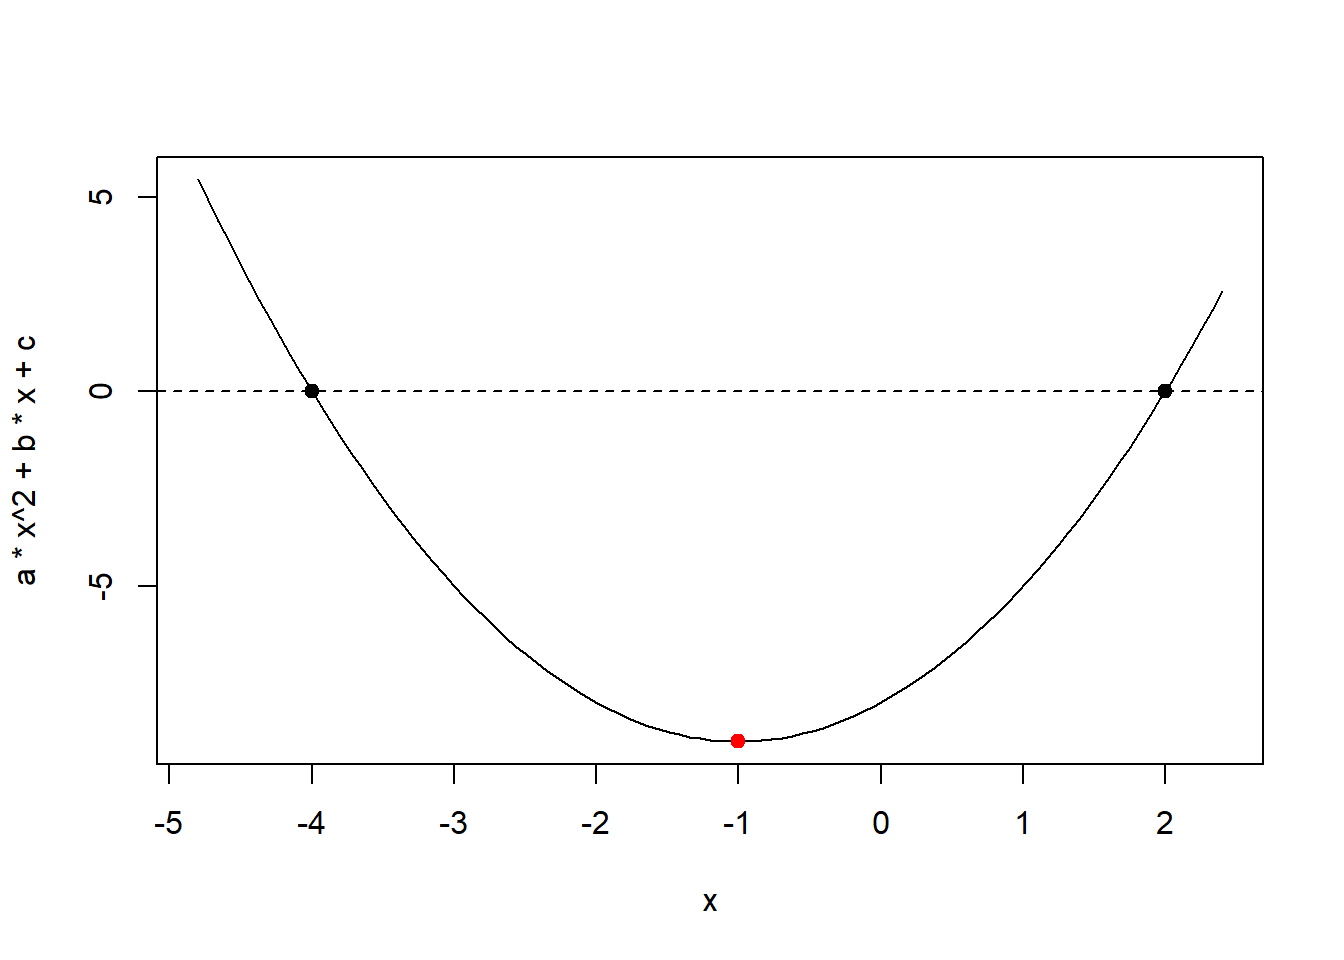
# EXEMPLO 3: fórmula de Bháskara# Encontrar as raízes de uma equação de segundo grau# Plotar a curvabhaskara <-function(a, b, c, plot =TRUE){ # a, b e c são os coeficientes da equação ax² + bx + c = 0 dentro_raiz <- b^2-4* a * cif(dentro_raiz <0){stop("Sem solução real") } delta <-sqrt(dentro_raiz) x1 <- (-b + delta) / (2* a) x2 <- (-b - delta) / (2* a) minx <-min(x1, x2) min_exp <-ifelse(minx <0, minx + minx *0.2, minx - minx *0.2) maxx <-max(x1, x2)# checa se precisa plotarif(isTRUE(plot)){# plot.new()# curvacurve(a * x^2+ b * x + c, xlim =c(min_exp, maxx + maxx *0.2))# pontos nas raízespoints(x =c(x1, x2),y =c(0, 0),col ="black",pch =19)# linha no zeroabline(h=0, lty=2) }# calcula o x e y do vértice x_vert <-round(-b / (2*a), 3)print(paste0("x: ", x_vert)) y_vert <-round(a * x_vert^2+ b * x_vert + c , 3)print(paste0("y: ", y_vert))# plota os pontos do vérticepoints(x = x_vert,y = y_vert,col ="red",pch =19)# retorna as raízesprint(paste0("Raízes: S{", x1, ";", x2, "}"))}bhaskara(1, -2, -3)
[1] "x: 1"
[1] "y: -4"
[1] "Raízes: S{3;-1}"
bhaskara(-1, 4, -3)
[1] "x: 2"
[1] "y: 1"
[1] "Raízes: S{1;3}"
bhaskara(1, 2, -8)
[1] "x: -1"
[1] "y: -9"
[1] "Raízes: S{2;-4}"
Operador pipe
Pipes são uma ferramenta poderosa para expressar claramente uma sequência de várias operações. Em resumo, o operador pipe fornece o resultado do lado esquerdo (LHS) do operador como o primeiro argumento do lado direito (RHS). O pipe %>% vem do pacote magrittr e faz parte da família de pacotes tidyverse, que serão explorados no decorrer deste material. O objetivo do pipe é ajudá-lo a escrever código de uma maneira mais fácil de ler e entender. A partir da versão 4.1.0, o R contém um pipe nativo, |>. Existem sutis diferenças entre eles, mas não é nosso objetivo aqui entrar nesse universo. Para mais detalhes, veja o vídeo abaixo.
Você pode habilitar o pipe nativo no RStudio em Tools > Global Options > Code, marcando a caixa indicada abaixo.
Para ver por que o pipe é tão útil, vamos explorar algumas maneiras de escrever o mesmo código. Para isso, considere as seguintes (e simples) operações:
Crie uma função que calcule o quadrado do desvio de cada termo em relação à média.
Crie um vetor com 10 dados aleatórios de uma distribuição normal com média 10 e desvio padrão 2, utilizando rnorm().
Calcule o quadrado dos desvios de cada valor em relação à média.
Some os valores.
Divida por n - 1.
Armazene o resultado no objeto var_amo.
# função para computar o quadrado dos desviosquadrado_desvio <-function(x){ (x -mean(x))^2}set.seed(1) # garante reprodutibilidade(x <-rnorm(n =10, mean =10, sd =2))
Note que a mesma operação pode ser realizada se você aninhar as funções.
(var_amo <-sum(sum(quadrado_desvio(x))) /9)
[1] 2.437258
Agora, utilizando o pipe, note como o código fica muito mais claro, pois as instruções são escritas na ordem em que precisam ser executadas.
var_amo <- x |>quadrado_desvio() |>sum() /9var_amo
[1] 2.437258
Tip
Se você ainda não percebeu, acabamos de reproduzir o que a função nativa do R var() faz para computar a variância amostral.
var(x)
[1] 2.437258
Avançado
Loops
Reescrever um código muitas vezes por necessidade de repetir um determinado procedimento seria bastante trabalhoso, além de exigir mais tempo e nos deixar mais propensos a erros, como, por exemplo, esquecer de trocar o nome de uma variável ou um coeficiente. Por isso, o R tem algumas estruturas que fazem essas repetições para nós. Isso é muito comum e pode ser facilmente implementado com for(), while() e repeat().
for()
O for() repete o código indicado dentro de {}n vezes, sendo n o comprimento da sequência dentro dos parênteses.
j <-5for (i in1:j){ k <- i *2print(k)}
[1] 2
[1] 4
[1] 6
[1] 8
[1] 10
while()
O while() (que significa “enquanto”) repete o código dentro de {} enquanto alguma condição for verdadeira. Isso é útil, por exemplo, em modelos que utilizam um algoritmo iterativo que necessita de convergência: o modelo é iterado até que a convergência seja atingida ou até que outra condição (por exemplo, um número máximo de iterações) seja satisfeita.
i <-1while (i <=5){print(i *2) i <- i +1}
[1] 2
[1] 4
[1] 6
[1] 8
[1] 10
Note que os dois últimos exemplos apresentam o mesmo resultado: para cada valor de i (de 1 a 5), o R retorna o resultado da multiplicação \(i \times 2\). No caso do while(), precisamos incrementar o valor de i manualmente para que a sequência continue enquanto a condição (i <= 5) for verdadeira. Além disso, precisamos declarar a variável (i <- 1) antes, para que o R possa testar a condição expressa dentro dos parênteses. No caso do for(), a sequência progride sem precisarmos fazer isso manualmente.
repeat()
No último exemplo, utilizando repeat(), o R repetirá o código dentro de {} sem condições. Por isso, precisamos utilizar a combinação de if() e break para informar ao programa quando o código deve parar de ser repetido.
i <-1repeat {print(i *2) i <- i +1if(i >5){break() }}
[1] 2
[1] 4
[1] 6
[1] 8
[1] 10
Imprimir números no console foi uma boa maneira de conhecermos como o procedimento for-loop funciona no R. Em resumo: podemos chegar ao mesmo resultado utilizando três abordagens distintas. Mas vamos dar um pouco mais de aplicabilidade aos procedimentos for-loop. Imagine que temos este simples data frame:
Bem, neste exemplo, as duas abordagens têm 5 linhas de programação, e realmente parece que o loop foi um tanto quanto mais “difícil” de implementar. Sua vantagem, no entanto, aparece quando muitas colunas estão disponíveis. Neste caso, se um conjunto de dados com 100 variáveis precisar ser analisado, as mesmas cinco linhas de programação são utilizadas.
Família apply
Nativamente, o R contém uma família de funções vetorizadas que minimizam a necessidade de criar loops explicitamente. Essas funções aplicam uma função especificada a um objeto de dados, e sua principal diferença está na classe de objeto na qual a função é aplicada (lista vs. matriz etc.) e na classe de objeto retornada.
apply()
A função apply() é mais frequentemente usada para aplicar uma função às linhas ou colunas (margens) de matrizes ou data frames. Note como o montante de código para calcular a média de cada coluna de df é drasticamente reduzido utilizando apply().
A função sapply() se comporta de maneira semelhante a lapply(); a única diferença está no valor retornado. sapply() tentará simplificar o resultado, se possível.
sapply(df, mean)
         a          b          c          d          e
 0.2488450 -0.1336732  0.1207302  0.1341367  0.1434569
Família map_*()
O padrão de fazer um loop sobre um vetor, fazer algo em cada elemento e salvar os resultados é tão comum que o pacote purrr fornece uma família de funções para fazer isso por você. Existe uma função para cada tipo de saída:
map() retorna uma lista.
map_lgl() retorna um vetor lógico.
map_int() retorna um vetor de números inteiros.
map_dbl() retorna um vetor double.
map_chr() retorna um vetor de caracteres.
library(purrr)
Warning: pacote 'purrr' foi compilado no R versão 4.5.3
         a          b          c          d          e
 0.2488450 -0.1336732  0.1207302  0.1341367  0.1434569
Combinando tudo até aqui
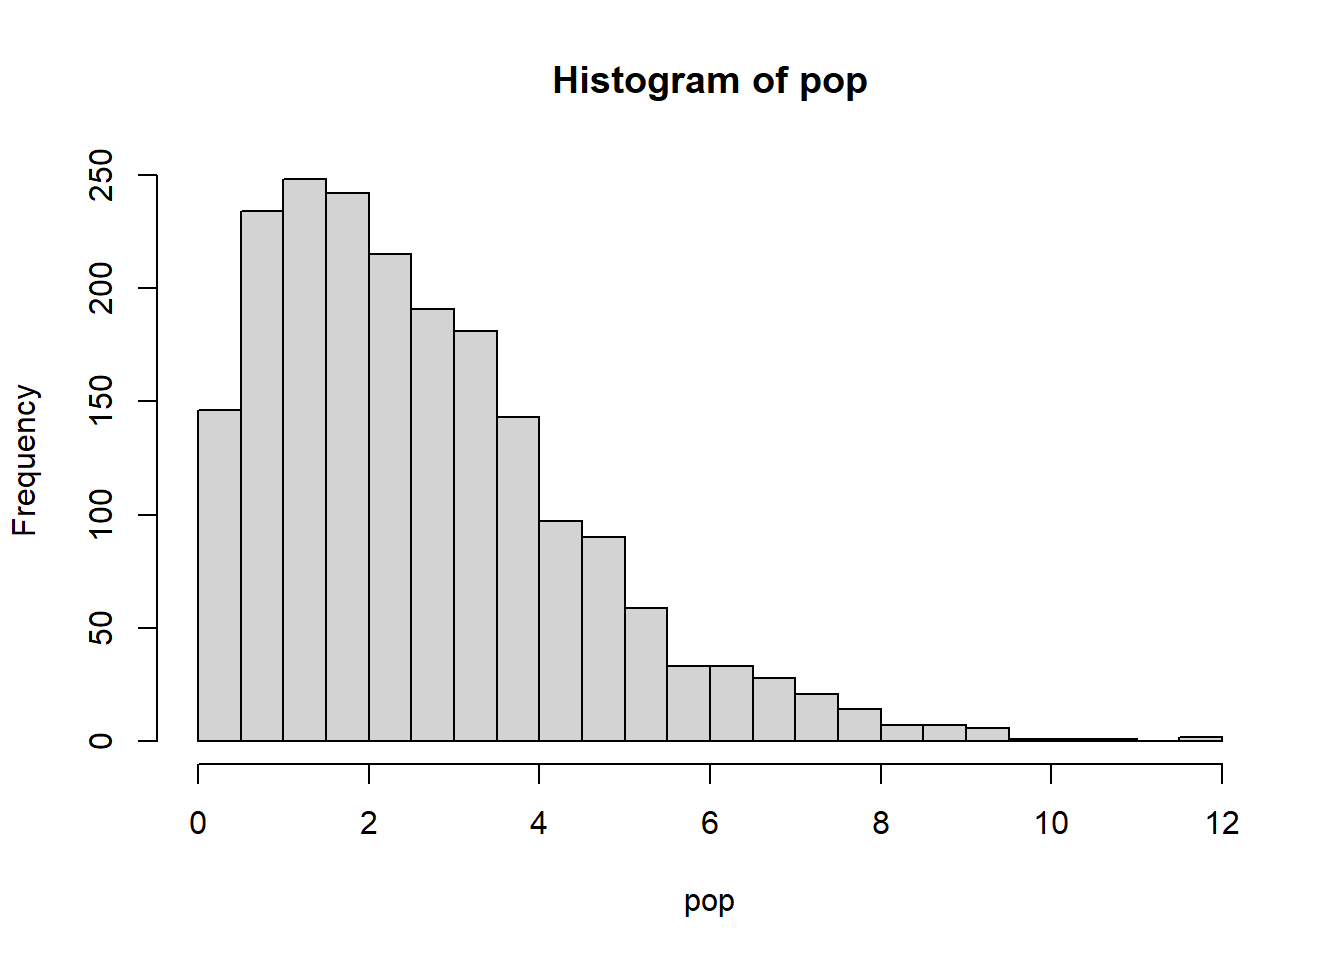
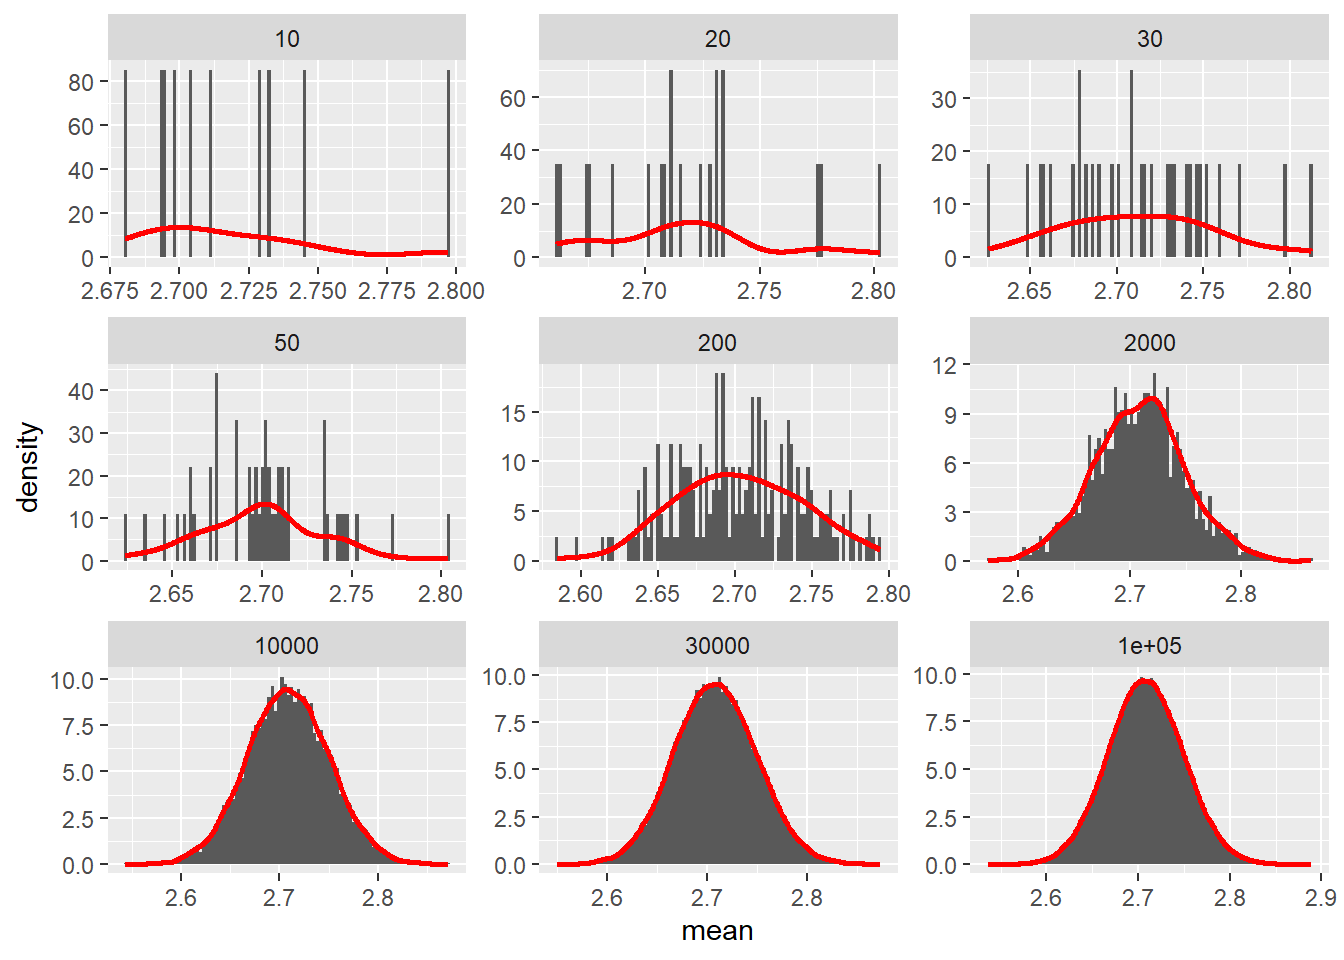
Nesta seção, vamos combinar os conhecimentos vistos até aqui para ilustrar o teorema central do limite1. Como população, utilizaremos uma distribuição Weibull com forma (shape) = 1,5 e escala (scale) = 3, claramente assimétrica. Em seguida, criamos uma função (teor_lim()) cujo argumento n define o número de amostragens realizadas; em cada amostragem, são gerados 2000 valores aleatórios dessa distribuição e calculada a sua média. Para a confecção dos histogramas, os pacotes ggplot2 e patchwork são utilizados.
library(ggplot2)
Warning: pacote 'ggplot2' foi compilado no R versão 4.5.3
library(patchwork)# forma da distribuiçãoset.seed(100)pop <-rweibull(2000, 1.5, 3)hist(pop, nclass =20)
# função que realiza n amostragens e retorna a média de cada umateor_lim <-function(n, pop){data.frame(mean =sapply(1:n, function(x){mean(rweibull(2000, 1.5, 3)) }),size = n)}# definir o número de amostragenssizes <-c(10, 20, 30, 50, 200, 2000, 10000, 30000, 100000)# criar a distribuição amostrallibrary(purrr)dist_amo <-map_dfr(sizes, teor_lim, pop)ggplot(dist_amo, aes(mean)) +geom_histogram(bins =100,aes(y = ..density..)) +geom_density(size =1, color ="red") +facet_wrap(~size, scales ="free")
Warning: Using `size` aesthetic for lines was deprecated in ggplot2 3.4.0.
ℹ Please use `linewidth` instead.
Warning: The dot-dot notation (`..density..`) was deprecated in ggplot2 3.4.0.
ℹ Please use `after_stat(density)` instead.
Homework
Criar um data frame com 10 observações e 3 variáveis quantitativas;
Converter o data frame para uma matriz;
Usar alguma das abordagens vistas (sapply(), for(), apply() etc.) para calcular a média de cada variável na matriz, armazenando-a em um vetor;
Subtrair de cada observação a média da respectiva variável;
Elevar os desvios ao quadrado;
Somar os desvios ao quadrado;
Dividir pelo número de observações menos 1 (n - 1).
Para fechar: o que levar deste módulo
Tudo no R é um objeto, e todo objeto tem uma classe. Na dúvida, pergunte ao R: class(), typeof() e str() são seus melhores amigos.
Vetores são a base de tudo: um vetor guarda elementos de um único tipo. Se você misturar números e textos com c(), o R converterá tudo para texto (coerção), uma fonte comum de erros.
Hierarquia das estruturas: vetor (1D) → matriz (2D, um tipo) → data frame/tibble (2D, tipos diferentes por coluna) → lista (qualquer coisa). Neste curso, o tibble será nossa estrutura padrão.
Indexação: [i] em vetores, [linha, coluna] em matrizes e data frames, [[i]] ou $nome para extrair um elemento de listas/data frames.
Escreva funções quando copiar e colar o mesmo código mais de duas vezes.
Pipe (|> ou %>%): leia como “e então”. Ele torna o código legível na ordem em que as operações acontecem e será usado em todos os próximos módulos.
Loops vs. vetorização: for() é ótimo para aprender a lógica, mas, no dia a dia, prefira funções vetorizadas (apply(), sapply(), map_*()), que são mais concisas e menos propensas a erros.
O teorema central do limite estabelece que a distribuição das médias amostrais se aproxima de uma distribuição normal à medida que o tamanho da amostra aumenta, independentemente da forma da distribuição da população.↩︎
Source Code
---title: "2. Introdução à programação R"editor_options: chunk_output_type: console---Neste módulo, serão vistos conceitos importantes da programação em R, envolvendo os tipos de objetos, as estruturas de dados e a lógica de programação.# Tipos de dados vs. Estruturas de dados {#sec-tipos-de-objetos}Para programar em R sem frustrações, o segredo é entender uma distinção fundamental:> **O tipo de dado** é o *conteúdo* (o "material" do qual o dado é feito: número, texto, lógico).> **A estrutura de dados** é o *recipiente* (a forma como esses dados são organizados no espaço: em fila, em tabela, em gavetas).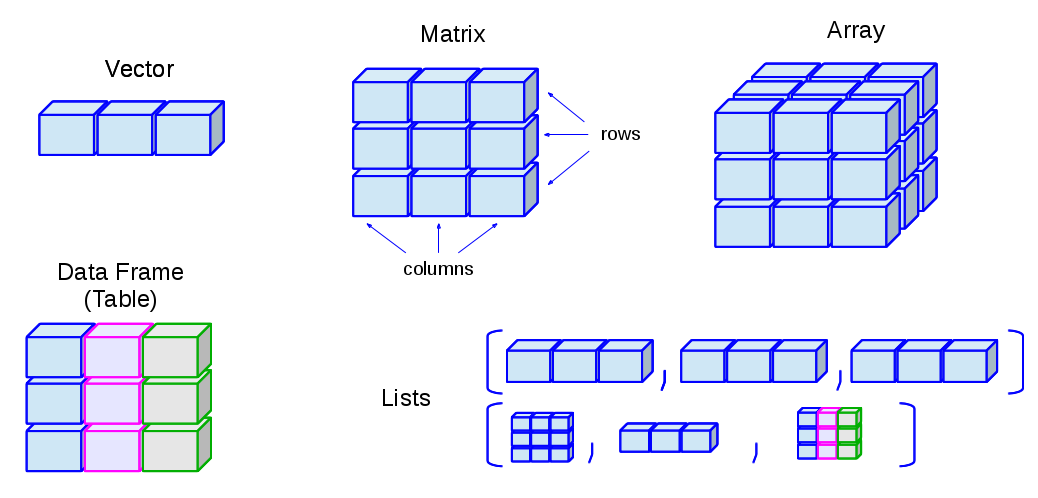Podemos resumir as estruturas em duas dimensões práticas:| Dimensões | Todos os elementos do mesmo tipo (Homogêneo) | Elementos de tipos diferentes (Heterogêneo) || :--- | :--- | :--- || **1D** (Fila) | **Vetor atômico** | **Lista** (o "armário de gavetas") || **2D** (Tabela) | **Matriz** | **Data frame** / **Tibble** (a "planilha") || **nD** (Multidimensional) | **Array** | *(não aplicável)* |---# 1. Os tipos atômicos de dados (o conteúdo)Antes de falarmos dos recipientes, vejamos os quatro tipos elementares que preenchem qualquer análise:1. **double** (numérico decimal): valores contínuos (ex., altura de planta 1.75, massa de grãos 28.4).2. **integer** (número inteiro): valores de contagem (ex., 3L repetições, 15L vagens). No R, acrescentamos um L maiúsculo ao final para forçar o tipo inteiro.3. **character** (texto / string): palavras, nomes ou códigos delimitados por aspas (ex., "Hibrido_A", "Bloco_1").4. **logical** (booleano): valores binários de verdadeiro ou falso (TRUE ou FALSE).`{r}# Exemplos escalares (um único elemento)estatura <- 1.82 # doublefolhas <- 12L # integercultivar <- "BRS Madrepérola" # characterirrigado <- TRUE # logicaltypeof(estatura)typeof(folhas)typeof(cultivar)typeof(irrigado)`---# 2. As estruturas de dados (os recipientes)Agora que conhecemos os materiais, vejamos os recipientes onde eles são guardados.## Vetor atômico: a fileira de tubetes homogênea> **Analogia:** Pense em um vetor como uma **fileira de tubetes para mudas**. Você pode encher todos os tubetes com terra (números) ou todos com substrato de casca de pinus (textos), mas **todos os tubetes daquela fileira devem conter o mesmo material**.A função c() (*combine* ou *concatenate*) é a ferramenta usada para criar vetores:`{r}# Vetor numérico (double)alturas <- c(1.65, 1.72, 1.80, 1.58)# Vetor de caracteres (strings)tratamentos <- c("Testemunha", "Dose_50", "Dose_100", "Dose_150")# Vetor lógicogerminadas <- c(TRUE, TRUE, FALSE, TRUE)`::: callout-caution## A regra de ouro dos vetores: Coerção automática!Se você tentar misturar tipos diferentes em um vetor, o R **não vai dar erro**; em vez disso, ele silenciosamente converterá todos os elementos para o tipo mais flexível (geralmente texto!). Isso se chama **coerção**:`{r}mistura <- c(10, 25.5, "Tratamento_A", TRUE)misturatypeof(mistura)`Note que os números e o TRUE viraram texto ("10", "25.5", "TRUE"). Cuidado com isso ao importar planilhas!:::### Sequências e repetições rápidasEm vez de digitar item por item, usamos funções utilitárias:`{r}# Sequências1:5 # De 1 a 5seq(from = 10, to = 50, by = 10) # De 10 a 50 de 10 em 10# Repetiçõesrep("Bloco_1", times = 4) # Repete 4 vezes o mesmo textorep(c("A", "B"), each = 3) # Repete cada elemento 3 vezes`### Acessando elementos do vetor com colchetes []Para puxar um elemento de uma posição específica da fileira, usamos [posicao]:`{r}alturas[1] # Primeiro valoralturas[c(1, 3)] # Primeiro e terceiro valoresalturas[-2] # Todos EXCETO o segundo valor`Além do uso de [], as funções irst(), last() e th() do pacote dplyr permitem selecionar o primeiro, o último e o i-ésimo elemento de forma expressiva:`{r message=FALSE, warning=FALSE}library(dplyr)first(alturas)last(alturas)nth(alturas, 2)`::: callout-important## Usamos <- ou = para atribuição de nomes a objetos?Em R, utilize sempre <- (atalho: Alt + -) para criar e atualizar objetos. O sinal de igualdade (=) deve ser reservado exclusivamente para definir argumentos dentro de funções (ex., mean(x, na.rm = TRUE)).:::---## Fator: a caixa de etiquetas de tratamentos> **Analogia:** Um fator é como uma **etiquetadora agrícola**. No campo, você não tem números contínuos para os tratamentos; você tem categorias bem definidas (níveis ou *levels*), como "Sol", "Sombra_30" e "Sombra_70".Por baixo dos panos, o R armazena os fatores como números inteiros (1, 2, 3), mas exibe rótulos compreensíveis. Isso é essencial para análises de variância (ANOVA) e modelos de regressão.`{r}ambiente <- factor(c("Campo", "Estufa", "Campo", "Estufa"))ambientelevels(ambiente) # Níveis possíveis da variável`---## Matriz: a bandeja de cultivo retangular> **Analogia:** Uma matriz é como uma **bandeja de cultivo retangular** com divisórias em linhas e colunas. Ela tem duas dimensões, mas **continua sendo homogênea** (todas as células precisam ser do mesmo tipo, quase sempre numérico).Construímos matrizes com a função matrix() ou juntando vetores com cbind() (colunas) e bind() (linhas):`{r}# Matriz de 3 linhas e 2 colunas(dados_campo <- matrix(1:6, nrow = 3, ncol = 2))# Indexação por [linha, coluna]dados_campo[2, 1] # Linha 2, Coluna 1dados_campo[1, ] # Toda a Linha 1dados_campo[, 2] # Toda a Coluna 2`---## Data Frame e Tibble: a planilha de campo> **Analogia:** Um data frame é o clássico **caderno de anotações de campo ou planilha do Excel**. Ele tem linhas (observações/plantas) e colunas (variáveis). A grande mágica: **cada coluna pode ter um tipo de dado diferente**, mas todas as colunas devem ter rigorosamente o **mesmo número de linhas**.- Coluna 1: Nome da planta (character)- Coluna 2: Bloco ( actor ou integer)- Coluna 3: Altura em metros (double)- Coluna 4: Sadia? (logical)`{r}# Criando um data frame tradicionalexperimento <- data.frame( planta = paste0("P_", 1:4), bloco = factor(rep(c("B1", "B2"), each = 2)), altura = c(1.45, 1.62, 1.58, 1.70), sadia = c(TRUE, TRUE, FALSE, TRUE))experimento`### Por que usamos o ibble?O ibble (do pacote ibble / ecossistema idyverse) é uma versão modernizada e mais amigável do data frame:1. Ao ser impresso no console, exibe o tipo de cada coluna (<chr>, <fct>, <dbl>, <lgl>) e evita travar o R quando há milhares de linhas.2. Não converte strings em fatores silenciosamente.3. Permite criar colunas novas que dependem de colunas recém-declaradas no mesmo comando.`{r message=FALSE, warning=FALSE}library(tibble)# Criando diretamente como tibbletbl_exp <- tibble( parcela = 1:4, prod_kg = c(2.4, 3.1, 2.8, 3.5), prod_g = prod_kg * 1000 # Usa a coluna anterior imediatamente!)tbl_exp`---## Lista: o armário de gavetas> **Analogia:** A lista é como um **armário gaveteiro de laboratório**. Cada gaveta tem uma etiqueta própria e, dentro de cada gaveta, você pode guardar **absolutamente qualquer coisa**, sem restrição de tamanho, dimensão ou tipo!>> - Na **Gaveta 1** ($projeto), guardamos um texto descritivo.> - Na **Gaveta 2** ($amostras), guardamos um vetor com números de amostras.> - Na **Gaveta 3** ($tabela), guardamos uma planilha inteira (um tibble)!> - Na **Gaveta 4** ($parametros), podemos guardar outra gaveta menor com notas técnicas (outra lista)!`{r}# Criando nossa lista (gaveteiro)gaveteiro <- list( projeto = "Avaliação de Linhaça 2026", # um texto amostras = c(101, 102, 103, 104, 105), # um vetor tabela = tbl_exp, # um tibble inteiro! responsavel = "Prof. Dr. Tiago Olivoto")`### Como abrir as gavetas e pegar o que está lá dentro?Existem duas formas principais de acessar os itens de uma lista:1. **Pelo nome da gaveta com o operador cifrão ($)**: a forma mais intuitiva e recomendada.2. **Pelo número da gaveta com colchetes duplos ([[ ]])**: abre a gaveta e retira diretamente o objeto de lá.`{r}# Puxando o tibble da gaveta 'tabela'gaveteiro# Puxando o vetor da gaveta 2 com [[ ]]gaveteiro[[2]]# Entrando na gaveta 'tabela' e pegando a coluna 'prod_kg':gaveteiro`::: callout-tip## Diferença crucial: [ ] vs [[ ]] em listas- gaveteiro[2] retorna uma **lista menor contendo a gaveta 2** (você ainda está segurando a gaveta com o item dentro).- gaveteiro[[2]] abre a gaveta e **retira o objeto que estava guardado dentro dela** (você pega o vetor na mão, pronto para usar em cálculos).:::# Lógica de programação::: callout-important## É preciso mesmo compreender programação?A programação é uma habilidade transversal necessária para todo o trabalho de ciência de dados (usando R ou não!). Resumidamente, a programação produz o código, e o código é uma ferramenta de comunicação entre você e o computador.:::## FunçõesUma das melhores maneiras de tornar o código mais eficiente é escrever funções. As funções são a base da linguagem *R*. Por meio de *argumentos* indicados em `function()`, uma expressão (ou série de expressões) é resolvida e um valor (ou um conjunto de valores) é retornado. As funções permitem automatizar tarefas comuns de uma maneira mais poderosa e geral do que "copiar e colar". Escrever uma função tem três grandes vantagens sobre o uso de copiar e colar:1. Você pode dar a uma função um nome evocativo que torne seu código mais fácil de entender.2. À medida que os requisitos mudam, você só precisa atualizar o código em um local, em vez de vários.3. Você elimina a chance de cometer erros acidentais ao copiar e colar (ex., atualizar um nome de variável em um local, mas não em outro).Considere escrever uma função sempre que copiar e colar um bloco de código mais de duas vezes. Quando uma função está armazenada no ambiente de trabalho, basta digitar o nome com o qual ela foi gravada. Os argumentos podem ser inseridos na ordem em que aparecem na função, sem especificar a qual argumento cada valor pertence. Caso a ordem de inserção dos argumentos seja diferente daquela em que aparecem na função, é preciso identificar a qual argumento cada valor pertence. Note que é possível combinar valores numéricos e texto como argumentos e/ou resultados de funções. Veja alguns exemplos.```{r, echo = TRUE, eval = TRUE, message = FALSE, warning = FALSE, error=TRUE}# EXEMPLO 1:# resolve a função 2x+1fun1 <- function(x){ # x é o único argumento da função a <- 2 * x + 1 return(a) # retorna a}fun1(2)fun1(x = 2) # explicita o argumento# EXEMPLO 2# função para elevar ao quadrado ou cubo# inclui condicionanteselevar <- function(x, eleva = "quadrado"){ if(!eleva %in% c("quadrado", "cubo")){ stop("O argumento eleva = ",eleva, " deve ser ou 'quadrado' ou 'cubo'") } if(eleva == "quadrado"){ valor <- ifelse(x^2 >= 1000, paste("O resultado (",x^2,") tem mais que 3 dígitos"), paste("O resultado (",x^2,") tem menos que 3 dígitos")) } if(eleva == "cubo"){ valor <- ifelse(x^3 >= 1000, paste("O resultado (",x^3,") tem mais que 3 dígitos"), paste("O resultado (",x^3,") tem menos que 3 dígitos")) } return(valor)}elevar(2) # usa o valor dos argumentos elevar(3, "cubo") # argumentos na sequência que eles aparecemelevar(eleva = "cubo", x = 15) # mudar a ordem dos argumentos# EXEMPLO 3: fórmula de Bháskara# Encontrar as raízes de uma equação de segundo grau# Plotar a curvabhaskara <- function(a, b, c, plot = TRUE){ # a, b e c são os coeficientes da equação ax² + bx + c = 0 dentro_raiz <- b^2 - 4 * a * c if(dentro_raiz < 0){ stop("Sem solução real") } delta <- sqrt(dentro_raiz) x1 <- (-b + delta) / (2 * a) x2 <- (-b - delta) / (2 * a) minx <- min(x1, x2) min_exp <- ifelse(minx < 0, minx + minx * 0.2, minx - minx * 0.2) maxx <- max(x1, x2) # checa se precisa plotar if(isTRUE(plot)){ # plot.new() # curva curve(a * x^2 + b * x + c, xlim = c(min_exp, maxx + maxx * 0.2)) # pontos nas raízes points(x = c(x1, x2), y = c(0, 0), col = "black", pch = 19) # linha no zero abline(h=0, lty=2) } # calcula o x e y do vértice x_vert <- round(-b / (2*a), 3) print(paste0("x: ", x_vert)) y_vert <- round(a * x_vert^2 + b * x_vert + c , 3) print(paste0("y: ", y_vert)) # plota os pontos do vértice points(x = x_vert, y = y_vert, col = "red", pch = 19) # retorna as raízes print(paste0("Raízes: S{", x1, ";", x2, "}"))}bhaskara(1, -2, -3)bhaskara(-1, 4, -3)bhaskara(1, 2, -8)```## Operador pipePipes são uma ferramenta poderosa para expressar claramente uma sequência de várias operações. Em resumo, o operador pipe fornece o resultado do lado esquerdo (LHS) do operador como o primeiro argumento do lado direito (RHS). O pipe `%>%` vem do pacote [magrittr](https://magrittr.tidyverse.org/index.html) e faz parte da família de pacotes [`tidyverse`](https://www.tidyverse.org/), que serão explorados no decorrer deste material. O objetivo do pipe é ajudá-lo a escrever código de uma maneira mais fácil de ler e entender. A partir da versão 4.1.0, o R contém um pipe nativo, `|>`. Existem sutis diferenças entre eles, mas não é nosso objetivo aqui entrar nesse universo. Para mais detalhes, veja o vídeo abaixo.{{< video https://www.youtube.com/embed/TmSwDAvPX2Q >}}Você pode habilitar o pipe nativo no RStudio em *Tools \> Global Options \> Code*, marcando a caixa indicada abaixo.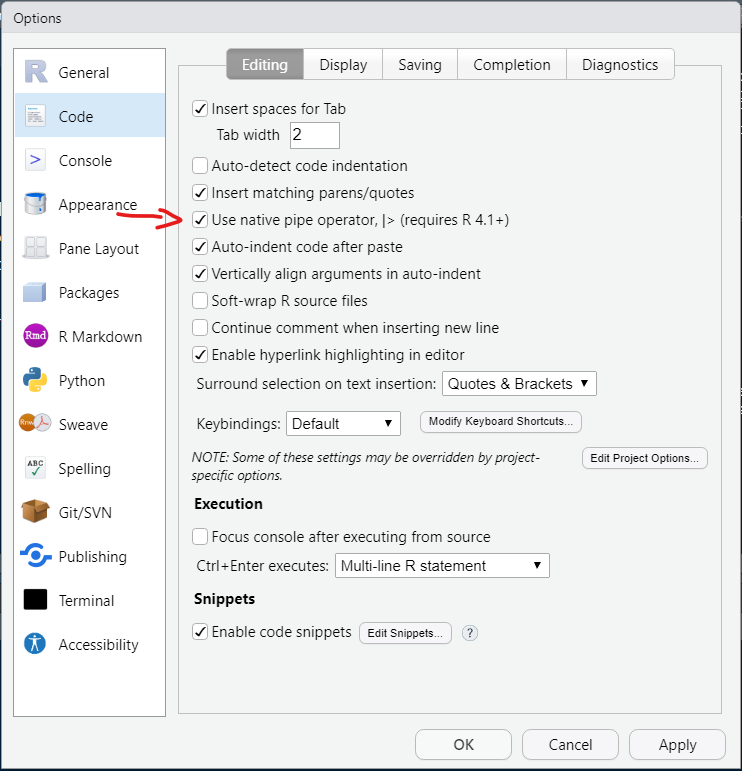Para ver por que o pipe é tão útil, vamos explorar algumas maneiras de escrever o mesmo código. Para isso, considere as seguintes (e simples) operações:> - Crie uma função que calcule o quadrado do desvio de cada termo em relação à média.> - Crie um vetor com 10 dados aleatórios de uma distribuição normal com média 10 e desvio padrão 2, utilizando `rnorm()`.> - Calcule o quadrado dos desvios de cada valor em relação à média.> - Some os valores.> - Divida por n - 1.> - Armazene o resultado no objeto `var_amo`.```{r}# função para computar o quadrado dos desviosquadrado_desvio <-function(x){ (x -mean(x))^2}set.seed(1) # garante reprodutibilidade(x <-rnorm(n =10, mean =10, sd =2))(quad_desv <-quadrado_desvio(x))(soma_quad_desv <-sum(quad_desv))(var_amo <-sum(soma_quad_desv) /9)```Note que a mesma operação pode ser realizada se você aninhar as funções.```{r}(var_amo <-sum(sum(quadrado_desvio(x))) /9)```Agora, utilizando o pipe, note como o código fica muito mais claro, pois as instruções são escritas na ordem em que precisam ser executadas.```{r}var_amo <- x |>quadrado_desvio() |>sum() /9var_amo```::: callout-tipSe você ainda não percebeu, acabamos de reproduzir o que a função nativa do R `var()` faz para computar a variância amostral.```{r}var(x)```:::# Avançado## Loops {#loops}Reescrever um código muitas vezes por necessidade de repetir um determinado procedimento seria bastante trabalhoso, além de exigir mais tempo e nos deixar mais propensos a erros, como, por exemplo, esquecer de trocar o nome de uma variável ou um coeficiente. Por isso, o R tem algumas estruturas que fazem essas repetições para nós. Isso é muito comum e pode ser facilmente implementado com `for()`, `while()` e `repeat()`.### `for()`O `for()` repete o código indicado dentro de `{}` *n* vezes, sendo *n* o comprimento da sequência dentro dos parênteses.```{r echo = TRUE, eval = TRUE, message = FALSE, warning = FALSE}j <- 5for (i in 1:j){ k <- i * 2 print(k)}```### `while()`O `while()` (que significa "enquanto") repete o código dentro de `{}` enquanto alguma condição for verdadeira. Isso é útil, por exemplo, em modelos que utilizam um algoritmo iterativo que necessita de convergência: o modelo é iterado até que a convergência seja atingida ou até que outra condição (por exemplo, um número máximo de iterações) seja satisfeita.```{r echo = TRUE, eval = TRUE, message = FALSE, warning = FALSE}i <- 1while (i <= 5){ print(i * 2) i <- i + 1}```Note que os dois últimos exemplos apresentam o mesmo resultado: para cada valor de `i` (de 1 a 5), o R retorna o resultado da multiplicação $i \times 2$. No caso do `while()`, precisamos incrementar o valor de `i` manualmente para que a sequência continue enquanto a condição `(i <= 5)` for verdadeira. Além disso, precisamos declarar a variável (`i <- 1`) antes, para que o R possa testar a condição expressa dentro dos parênteses. No caso do `for()`, a sequência progride sem precisarmos fazer isso manualmente.### `repeat()`No último exemplo, utilizando `repeat()`, o R repetirá o código dentro de `{}` sem condições. Por isso, precisamos utilizar a combinação de `if()` e `break` para informar ao programa quando o código deve parar de ser repetido.```{r echo = TRUE, eval = TRUE, message = FALSE, warning = FALSE}i <- 1repeat { print(i * 2) i <- i + 1 if(i > 5){ break() }}```### Imprimir números no console foi uma boa maneira de conhecermos como o procedimento *for-loop* funciona no R. Em resumo: podemos chegar ao mesmo resultado utilizando três abordagens distintas. Mas vamos dar um pouco mais de aplicabilidade aos procedimentos *for-loop*. Imagine que temos este simples data frame:```{r}df <-data.frame(a =rnorm(10),b =rnorm(10),c =rnorm(10),d =rnorm(10),e =rnorm(10))df```Agora, imagine que você quer computar a média de cada variável. Você poderia fazer isso copiando e colando 5 vezes o código.```{r}mean(df$a)mean(df$b)mean(df$c)mean(df$d)mean(df$e)```Usando o *for-loop*, teríamos um vetor de médias com o seguinte código:```{r}output <-NULL# 1. outputfor (i in1:ncol(df)) { # 2. Sequência output[i] <-mean(df[[i]]) # 3. o que é executado dentro de cada loop}output```Bem, neste exemplo, as duas abordagens têm 5 linhas de programação, e realmente parece que o loop foi um tanto quanto mais "difícil" de implementar. Sua vantagem, no entanto, aparece quando muitas colunas estão disponíveis. Neste caso, se um conjunto de dados com 100 variáveis precisar ser analisado, as mesmas cinco linhas de programação são utilizadas.## Família `apply`Nativamente, o R contém uma família de funções vetorizadas que minimizam a necessidade de criar loops explicitamente. Essas funções aplicam uma função especificada a um objeto de dados, e sua principal diferença está na classe de objeto na qual a função é aplicada (lista vs. matriz etc.) e na classe de objeto retornada.### `apply()`A função `apply()` é mais frequentemente usada para aplicar uma função às linhas ou colunas (margens) de matrizes ou data frames. Note como o montante de código para calcular a média de cada coluna de `df` é drasticamente reduzido utilizando `apply()`.```{r}apply(df, 1, mean) # média das linhasapply(df, 2, mean) # média das colunas```### `lapply()`A função `lapply()` faz a seguinte série simples de operações:1. Faz um *loop* em uma lista, iterando sobre cada elemento dessa lista;2. Aplica uma função (especificada por você) a cada elemento da lista;3. Retorna uma lista (o "l" é de "lista").```{r}lapply(df, mean)```### `sapply()`A função `sapply()` se comporta de maneira semelhante a `lapply()`; a única diferença está no valor retornado. `sapply()` tentará simplificar o resultado, se possível.```{r}sapply(df, mean)```## Família `map_*()`O padrão de fazer um *loop* sobre um vetor, fazer algo em cada elemento e salvar os resultados é tão comum que o pacote [`purrr`](https://purrr.tidyverse.org/) fornece uma família de funções para fazer isso por você. Existe uma função para cada tipo de saída:- `map()` retorna uma lista.- `map_lgl()` retorna um vetor lógico.- `map_int()` retorna um vetor de números inteiros.- `map_dbl()` retorna um vetor *double*.- `map_chr()` retorna um vetor de caracteres.```{r}library(purrr)map(df, mean) # retorna uma listamap_dbl(df, mean) # retorna um vetor double```# Combinando tudo até aquiNesta seção, vamos combinar os conhecimentos vistos até aqui para ilustrar o teorema central do limite[^2]. Como população, utilizaremos uma [distribuição Weibull](https://pt.wikipedia.org/wiki/Distribui%C3%A7%C3%A3o_de_Weibull) com forma (*shape*) = 1,5 e escala (*scale*) = 3, claramente assimétrica. Em seguida, criamos uma função (`teor_lim()`) cujo argumento `n` define o número de amostragens realizadas; em cada amostragem, são gerados 2000 valores aleatórios dessa distribuição e calculada a sua média. Para a confecção dos histogramas, os pacotes [`ggplot2`](https://ggplot2.tidyverse.org/) e [`patchwork`](https://patchwork.data-imaginist.com/) são utilizados.[^2]: O teorema central do limite estabelece que a distribuição das médias amostrais se aproxima de uma distribuição normal à medida que o tamanho da amostra aumenta, independentemente da forma da distribuição da população.```{r}#| out-width: "100%"library(ggplot2)library(patchwork)# forma da distribuiçãoset.seed(100)pop <-rweibull(2000, 1.5, 3)hist(pop, nclass =20)# função que realiza n amostragens e retorna a média de cada umateor_lim <-function(n, pop){data.frame(mean =sapply(1:n, function(x){mean(rweibull(2000, 1.5, 3)) }),size = n)}# definir o número de amostragenssizes <-c(10, 20, 30, 50, 200, 2000, 10000, 30000, 100000)# criar a distribuição amostrallibrary(purrr)dist_amo <-map_dfr(sizes, teor_lim, pop)ggplot(dist_amo, aes(mean)) +geom_histogram(bins =100,aes(y = ..density..)) +geom_density(size =1, color ="red") +facet_wrap(~size, scales ="free")```::: callout-tip## Homework- Criar um data frame com 10 observações e 3 variáveis quantitativas;- Converter o data frame para uma matriz;- Usar alguma das abordagens vistas (`sapply()`, `for()`, `apply()` etc.) para calcular a média de cada variável na matriz, armazenando-a em um vetor;- Subtrair de cada observação a média da respectiva variável;- Elevar os desvios ao quadrado;- Somar os desvios ao quadrado;- Dividir pelo número de observações menos 1 (n - 1).:::::: callout-tip## Para fechar: o que levar deste módulo- **Tudo no R é um objeto**, e todo objeto tem uma classe. Na dúvida, pergunte ao R: `class()`, `typeof()` e `str()` são seus melhores amigos.- **Vetores são a base de tudo**: um vetor guarda elementos de *um único tipo*. Se você misturar números e textos com `c()`, o R converterá tudo para texto (coerção), uma fonte comum de erros.- **Hierarquia das estruturas**: vetor (1D) → matriz (2D, um tipo) → data frame/tibble (2D, tipos diferentes por coluna) → lista (qualquer coisa). Neste curso, o **tibble** será nossa estrutura padrão.- **Indexação**: `[i]` em vetores, `[linha, coluna]` em matrizes e data frames, `[[i]]` ou `$nome` para extrair um elemento de listas/data frames.- **Escreva funções** quando copiar e colar o mesmo código mais de duas vezes.- **Pipe (`|>` ou `%>%`)**: leia como "e então". Ele torna o código legível na ordem em que as operações acontecem e será usado em todos os próximos módulos.- **Loops vs. vetorização**: `for()` é ótimo para aprender a lógica, mas, no dia a dia, prefira funções vetorizadas (`apply()`, `sapply()`, `map_*()`), que são mais concisas e menos propensas a erros.:::```{=html}<div align='center'><a href='https://www.free-website-hit-counter.com'><img src='https://www.free-website-hit-counter.com/c.php?d=9&id=141634&s=2' border='0' alt='Free Website Hit Counter'></a><br / ><small><a href='https://www.free-website-hit-counter.com' title="Free Website Hit Counter">Free website hit counter</a></small></div>```